
Kimi K3 在发布之际便席卷全球,横扫各大榜单,确立了其开源前沿模型的地位。社区渴望了解 Kimi K3 的工作原理,而许多人对其性能背后的非常规技术感到惊讶。本文旨在为理解 Kimi K3 模型架构的核心技术提供一个入门指南。
Kimi Delta Attention(KDA)是 Kimi K3 混合注意力机制中的线性注意力层。我们沿着 KDA 的起源脉络,从线性注意力(linear attention)、DeltaNet、门控 DeltaNet(Gated DeltaNet,GDN)一路讲到 KDA。
线性注意力的推导源于移除标准 softmax 注意力中的 softmax 运算。下面我们对比迭代推理公式,它展示了在 token 位置 t 处输出向量的计算过程:
来源:DeltaNet Explained(第 I 部分)
移除 softmax 运算后,我们可以重新排列运算顺序,将注意力的计算复杂度从二次方降至线性:

来源:Linear Attention and Beyond(与杨松林(Songlin Yang)的交互式教程)
新的公式如下:
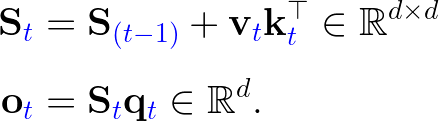
来源:Linear Attention and Beyond(与杨松林(Songlin Yang)的交互式教程)
向量 q、k、v 的维度为 L×d。两个公式的计算复杂度均为 O(Ld²),因此计算是线性的。将新公式与 softmax 注意力的公式对比,我们可以看到 softmax 注意力需要访问所有历史的 key 和 value 向量,而线性注意力将所有历史的 key 和 value 向量压缩到一个隐状态 S 中。
我们将新公式重新解读为一个在线学习目标。把矩阵 S 视为联想记忆(associative memory),它存储 key 向量 k 与 value 向量 v 之间的关联,通过将 S 与 k 相乘来检索 v。由此,第一个公式可理解为在每个位置不断更新矩阵 S 以完善检索。最后,vt @ kt.T 这一项可以解释为损失函数 -(S @ kt.T) @ vt 对 S 的梯度。
\[
\begin{aligned}
\textbf{Objective:}\quad
\mathcal{L}_t(\mathbf{S})
&=
-\left\langle
\mathbf{S}\mathbf{k}_t,\mathbf{v}_t
\right\rangle
\\[8pt]
\textbf{SGD update:}\quad
\mathbf{S}_t
&=
\mathbf{S}_{t-1}
-\beta_t\nabla\mathcal{L}_t(\mathbf{S}_{t-1})
\\
&=
\mathbf{S}_{t-1}
+\beta_t\mathbf{v}_t\mathbf{k}_t^\top
\end{aligned}
\]
从在线学习目标的角度看,矩阵 S 的值会无界增长:随着序列变长,新旧信息在 S 中逐渐模糊混杂,导致学习不稳定。由于缺少 softmax 提供的良好缩放与有界输出,线性注意力在长距离召回任务上通常落后于 softmax 注意力。
DeltaNet 对线性注意力的改进在于将损失函数改为最小化值检索的 L2 范数。与线性注意力的损失函数不同,DeltaNet 的损失函数对 S 的增长进行了正则化。由此产生了一个新的矩阵 S 更新规则——Delta 规则(Delta Rule),如下所示:
\[
\begin{aligned}
\textbf{Objective:}\quad
\mathcal{L}_t(\mathbf{S})
&=
\frac{1}{2}
\left\|
\mathbf{S}\mathbf{k}_t-\mathbf{v}_t
\right\|^2
\\[6pt]
\textbf{SGD update:}\quad
\mathbf{S}_t
&=
\mathbf{S}_{t-1}
-\beta_t\nabla\mathcal{L}_t\!\left(\mathbf{S}_{t-1}\right)
\\
&=
\mathbf{S}_{t-1}
-\beta_t
\left(
\mathbf{S}_{t-1}\mathbf{k}_t-\mathbf{v}_t
\right)
\mathbf{k}_t^\top
\end{aligned}
\]
来源:Linear Attention and Beyond(与杨松林(Songlin Yang)的交互式教程)
Delta 规则成为 DeltaNet 注意力公式的基础:
\[
\mathbf{S}_t
=
\mathbf{S}_{t-1}
-
\beta_t
\left(
\mathbf{S}_{t-1}\mathbf{k}_t-\mathbf{v}_t
\right)
\mathbf{k}_t^\top
\]
从概念上讲,Sₜ₋₁ @ kₜ - vₜ 表示与当前 key 和 value 无关的关联,DeltaNet 会针对性地移除这些关联。
GDN 和 KDA 都是 DeltaNet 的改进版本。门控 DeltaNet 将 LSTM 遗忘门(forget gate)alpha 应用于矩阵 S,使模型能够通过权重衰减控制记忆的寿命。KDA 进一步将 alpha 扩展为对角矩阵,实现了细粒度的逐通道记忆衰减和位置感知。

来源:Kimi Linear
Moonshot(月之暗面)开发了其针对 KDA 的定制内核 FlashKDA,并已开源。这里我们解释该算法并推导其算术强度(arithmetic intensity)。
首先,我们从循环公式的另一种形式出发:
这里 D_t 是 alpha 遗忘门的对角矩阵,u_t 是 delta 规则中的 delta。对于解码(decode),内核大致遵循该公式。对于预填充(prefill),我们按 token 分块展开循环公式来并行化运算,以便在 GPU 上高效执行。假设我们将 token i 到 j 展开,起始状态为 Sᵢ₋₁,则得到:
D_j:i 表示从 token i 到 j 的累计衰减:D_j @ D_j-1 @ D_j-2 @ … @ D_i。在 FlashKDA 的矩阵形式中,公式变为:
从向量到矩阵的映射如下:
S_in 指分块起始位置的状态
S_out 指分块结束位置的状态
K_restore 是 D_j:t+1 @ k_t 的矩阵形式
Q_decay 是 q_j.T @ D_j:i 的矩阵形式
Q_decay @ K_inv.T 是 q_j.T @ D_j:t+1 @ k_t 的矩阵形式,由 (q_j.T @ D_j:i) @ (D_t:i^-1 @ k_t) 推导而来
M_qk 是因果掩码(causal mask),因此是一个下三角矩阵
U 是展开后的 u_t 的矩阵形式。为计算它,我们应用 UT 变换并计算以下内容:
完整推导请参阅杨松林(Songlin Yang)的博客文章和 Kimi Linear 论文第 3.1 节。请注意,这里的 U 对应 Kimi Linear 论文中的伪值(pseudo-value)项。
实现上,FlashKDA 启动两个内核:K1 和 K2。K1 并行准备分块级张量,包括:
其中 a 是累计衰减,每个元素对应某个 token 位置的累计衰减。
K2 执行分块级循环计算:
这里我们分析单个注意力头的复杂度。对于解码,关键路径的计算为:
解码内核大约执行 7*D² 次 FLOPs。
读取和写入 FP32 循环状态主导了内存流量,因此内存流量约为 8*D² 字节。
对于预填充,K1 的关键路径在于计算 L、INV 和 M_qk。
对于 K2:
综合 K1 和 K2,FlashKDA 执行 12*C³ + 8*C²*D + 6*C*D² 次 FLOPs。由于我们在分块级别(分块大小 C)进行分析,假设序列长度 T >> C,则总 FLOPs 为 T/C * O(C*D²) = O(T*D²)。
对于内存流量:
总体而言,FlashKDA 访问 3 * 2*C*D + 2 * (3 * 2*C*D + 2 * 2*C*C) + 2 * 2*C*D = 8*C² + 22*C*D 字节。在内核层面,它访问 T/C * (8*C² + 22*C*D) + 8*D² ~ O(TC + TD + D²) 字节。
这具体地展示了 KDA 的计算复杂度:
Moonshot 训练了 Kimi Linear 模型作为其 KDA 设计的概念验证,因此我们可以从 Kimi Linear 推断 Kimi K3 的架构设计。将 K3 发布技术博客与 Kimi Linear 对比,可以看到 Kimi K3 沿用了共享专家数量、混合线性注意力比例以及整体注意力模块设计。

来源:SemiAnalysis

来源:Kimi K3 技术博客
上图展示了对 KDA 输入执行的操作。对于 query、key 和 value,我们应用线性变换和短卷积(short convolution)。短卷积能有效捕捉局部的 token 依赖,采用左填充卷积可避免破坏因果性。我们还对 query 和 key 应用 L2 范数,以稳定转移矩阵和输出矩阵的特征向量。对于衰减记忆门,alpha 是一个低秩投影,beta 是一个降维投影。KDA 的输出按头归一化,并由一个输出遗忘门控制——在 K3 中以线性变换实现,而在 Kimi Linear 中则是低秩投影。最后,我们应用一个线性层来混合各头的信息。
Kimi Linear 将 KDA 与全注意力的多潜变量注意力(Multi-head Latent Attention,MLA)交替排列。Kimi Linear 表明,KDA 与 MLA 的比例 3:1 是平衡性能与效率的理想选择。KDA 同时也是一个强大的位置感知算子,取代了 MLA 中的 RoPE。
与此前使用 MLA 的实验室不同,Moonshot 保留了 MLA 层作为全注意力。具体来说,智谱(Zhipu)如今使用 DeepSeek 稀疏注意力(DeepSeek Sparse Attention,DSA),DeepSeek 又将 DSA 进一步演进为压缩稀疏注意力(Compressed Sparse Attention)和重度压缩注意力(Heavily Compressed Attention)。Moonshot 最杰出的研究员之一苏剑林(Jianlin Su)为这一决定给出了两个理由:他们尚未找到更好的注意力设计,同时也不想一次性引入过多的模型架构改动。MLA 并不适合智能体(agentic)工作负载,下面我们将解释原因。
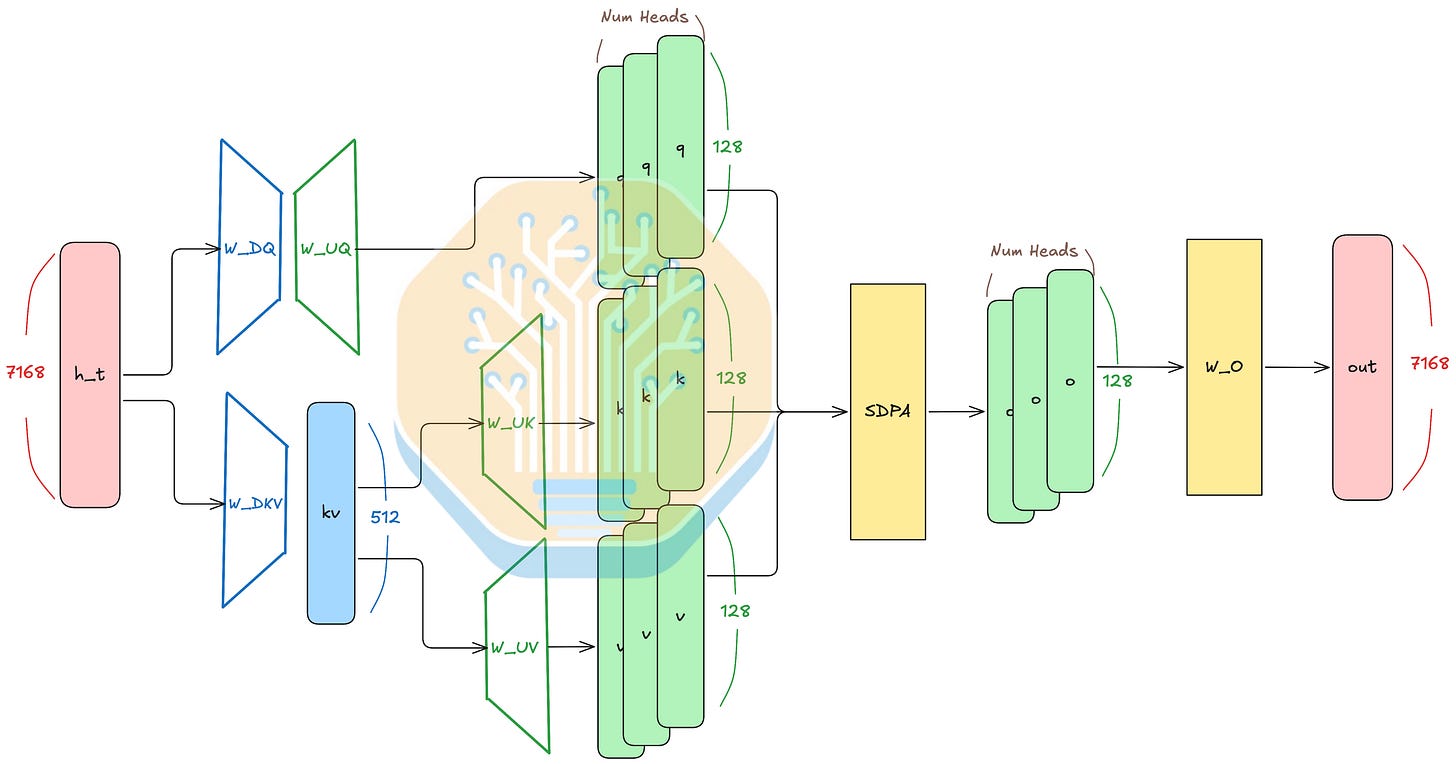
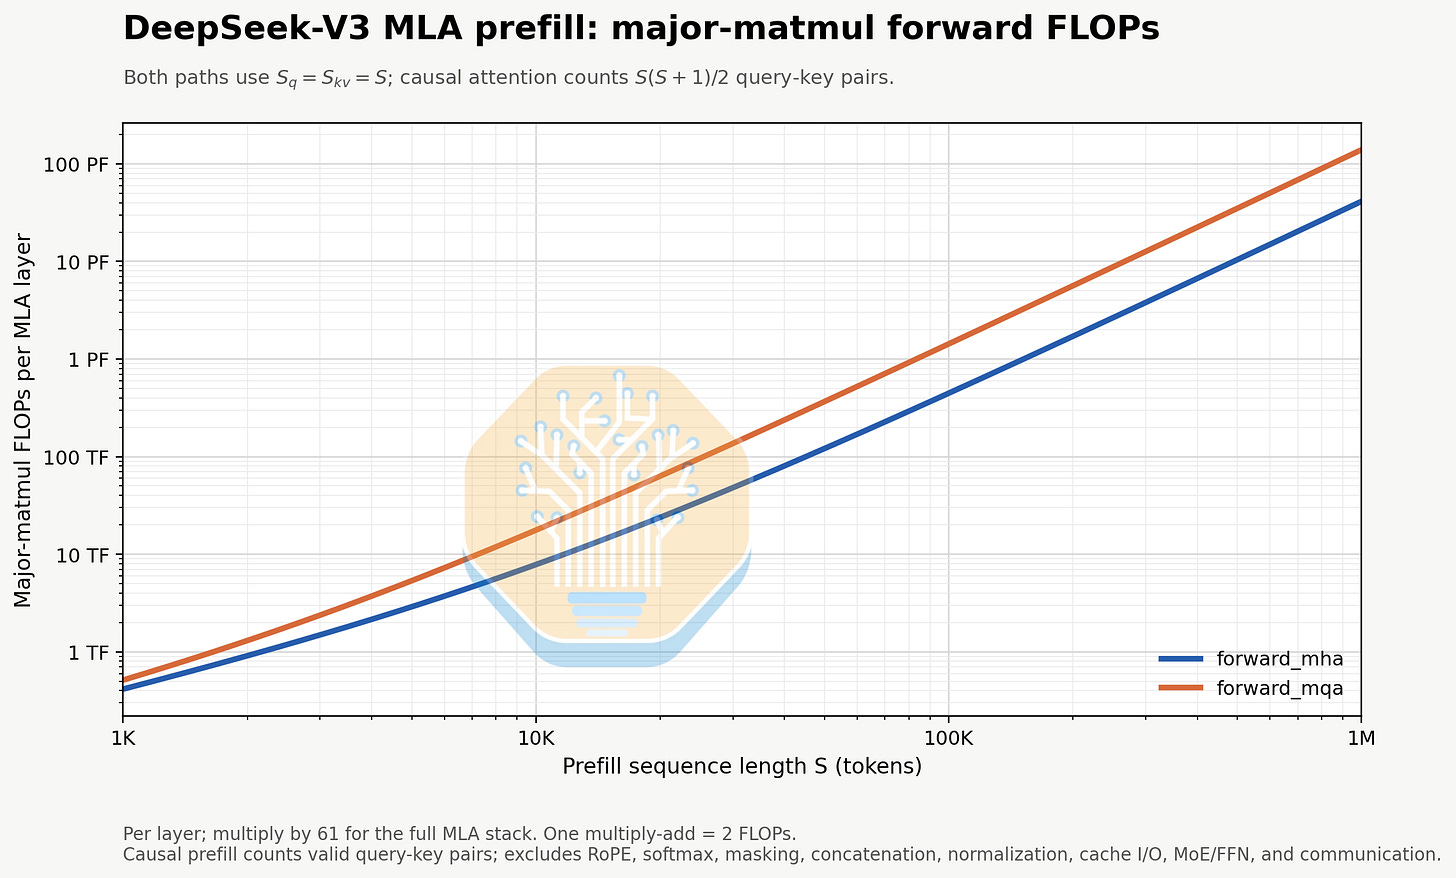
MLA 在预填充和解码阶段执行不同的运算。DeepSeek V3.2 论文定义了 MLA 的两种模式:多头注意力(Multi-head attention,MHA)模式和多查询注意力(Multi-query attention,MQA)模式。为简化起见,这里省略 RoPE 维度,并以 DeepSeek V3 的配置为例。
来源:SemiAnalysis
MHA 模式是 MLA 在预填充时的默认模式。在 MHA 模式下:
MHA 模式与 MQA 模式之间的关键联系在于什么被用作 KV cache。我们保存 KV 条目 kv 而非 keys 和 values 作为解码的 KV cache。通过保存 KV 条目,每个 token 的内存占用减少了 42.67 倍。
来源:SemiAnalysis
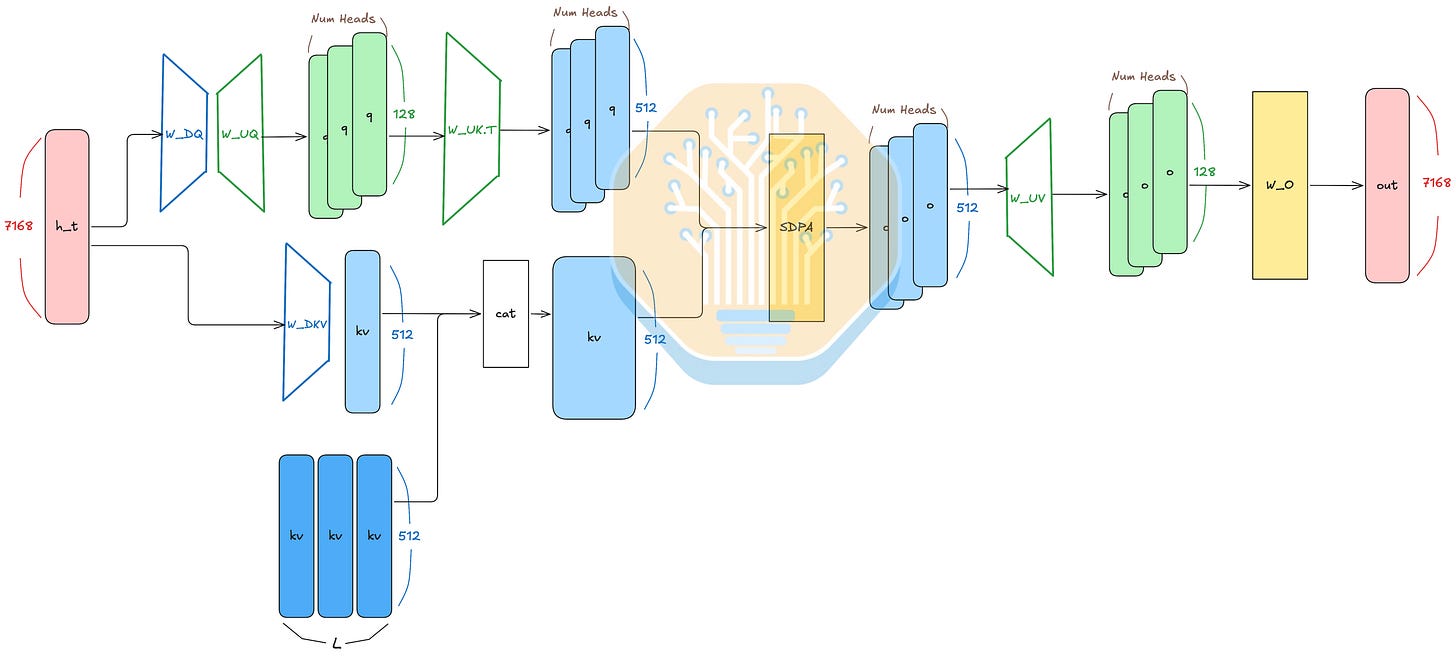
MQA 模式是 MLA 在解码时的默认模式。为避免重新物化完整的 KV cache,我们重新排列了注意力周围的运算顺序,推导如下:
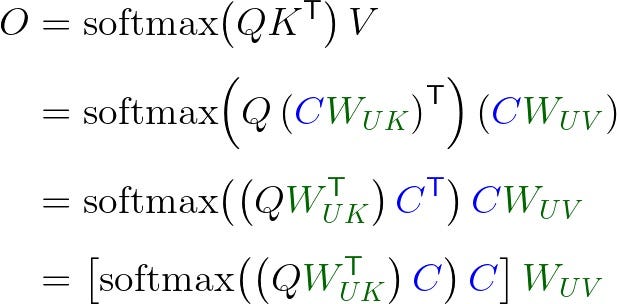
重新排列后,差异如下:
如图所示,query 是多头的,而 KV 条目是单头的。这实际上就是多查询注意力,故得此名。
对比 MHA 与 MQA 模式的 FLOPs,我们首先可以消去 query 低秩投影和输出线性投影。随后我们发现,无论 KV 升维投影在何处应用,其产生的 FLOPs 大致相当。
剩下的就是 SDPA。SDPA 执行三次矩阵乘法:(Q @ K.T) @ V,因此 FLOPs 数量为 L * d * L + L * L * d = 2*d*L²。MHA 模式在标准模型头维度 128 下执行,而 MQA 模式在潜变量维度 512 下执行。这意味着相比 MHA 模式,MQA 模式的 SDPA 大约多出 4 倍 FLOPs,整体上每个 token 最多可能产生 3.4 倍 FLOPs。
MLA 非常适合推理(reasoning)工作负载。推理通常以相对较短的输入序列开始,随后产生大量输出 token。每个输出 token 是一次解码步骤,MLA 更小的每 token KV cache 降低了内存带宽需求,从而加快解码速度。
然而,智能体工作负载的表现则不同。智能体工作负载涉及工具调用,而工具调用会返回较长的输出。这意味着模型经常处于这样一种情况:序列是一段较长的已缓存输入,随后紧跟一段较长的需要预填充的序列。这类工作负载被称为追加预填充(append-prefill,也称 extend、append、增量预填充)。
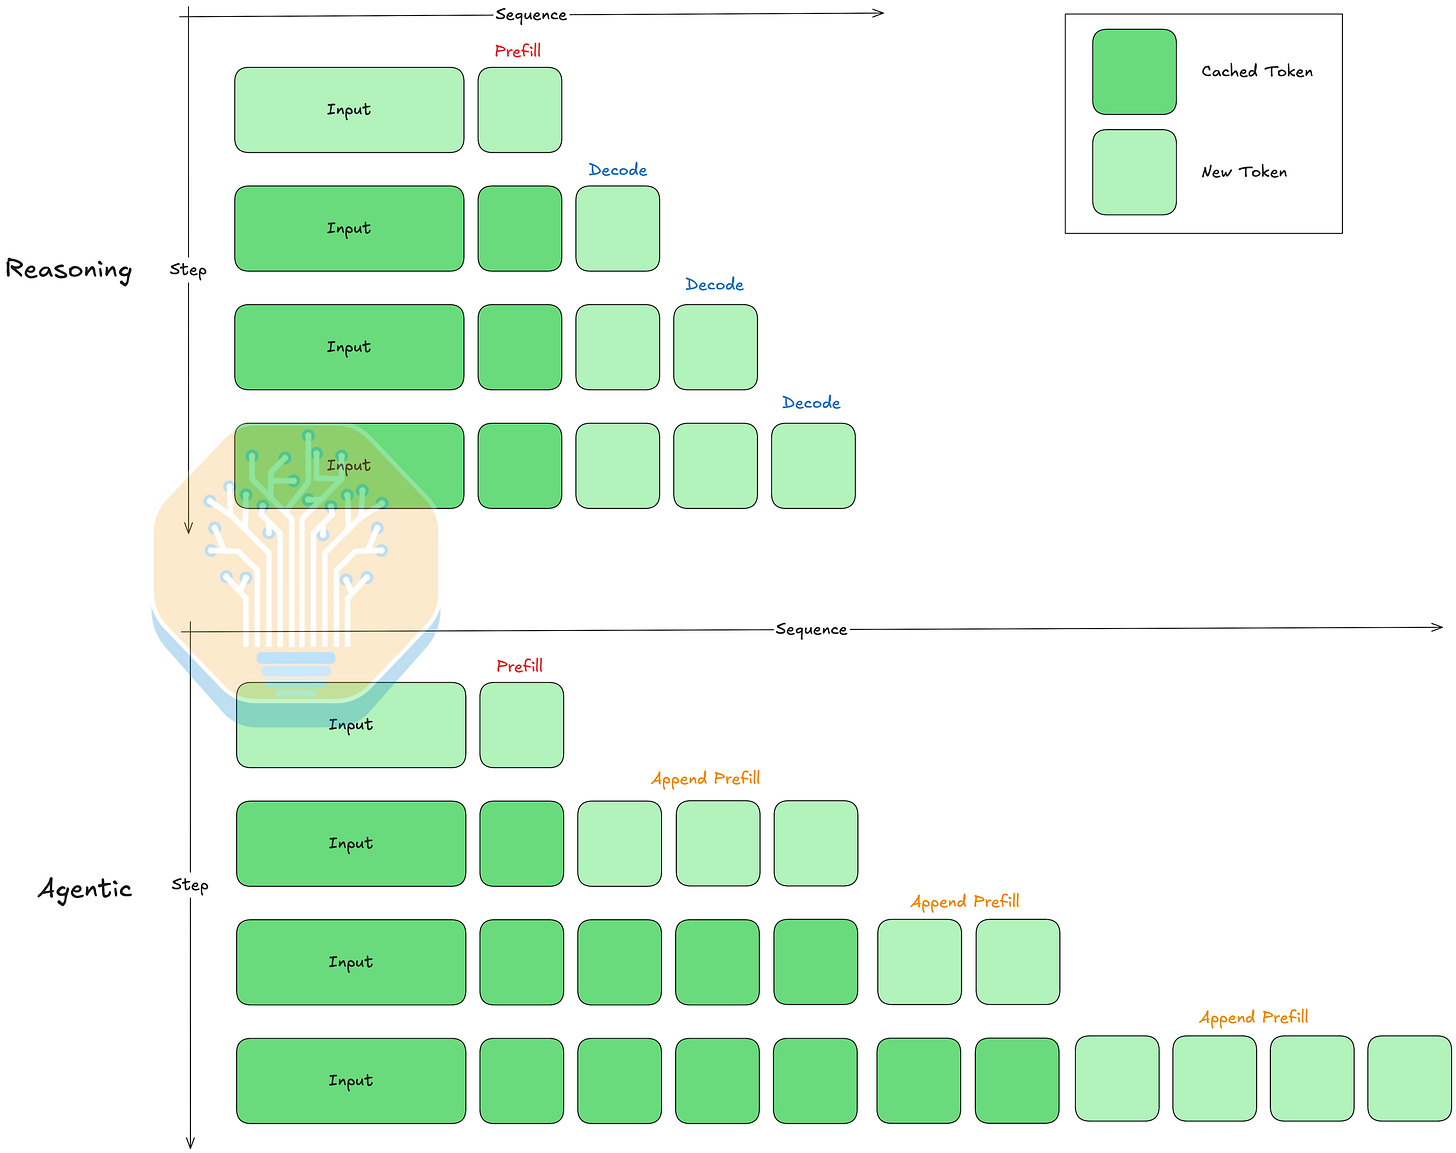
MLA 的两种模式都不适合追加预填充。MHA 模式不理想,因为物化完整的 KV cache 内存开销太大;而 MQA 模式也不合适,因为存在 3.4 倍的 FLOPs 开销。正如这条 Twitter 讨论串中所讨论的,现代推理引擎(vLLM、SGLang)选择 MHA 模式,但应用分块预填充(chunked prefill)技术来避免物化整个上下文的 KV cache。为解决智能体工作负载的这一问题,DeepSeek 和智谱选择将 MQA 模式改造为稀疏注意力以降低 FLOPs。我们推测 Moonshot 未来的模型(如 Kimi K4)将采用替代 MLA 的注意力机制。
我们认为,不应仅仅依据 KV cache 的空间复杂度来推断 KV cache 效率。KV cache 大小并非一个独立因素,而是模型设计的一个属性:没有任何开源权重模型带有静态 KV cache 压缩技术发布,且模型架构的推理效率也会影响 KV cache 效率。KV cache 大小的影响还取决于所部署模型实例的总内存容量。例如,采用宽专家并行(EP)部署的模型与采用张量并行(TP)部署的模型,其内存画像截然不同,这会影响到留给 KV cache 的内存容量。因此,我们建议同时考虑模型架构的系统效率和 KV cache 大小来理解 KV cache 效率,并用 KV 吞吐量(KV throughput)来量化。
KV 吞吐量定义为:给定特定序列长度时,KV cache 大小除以预填充时间(首 token 时间,Time to first token)。KV 吞吐量代表了在 PD 分离(PD disaggregation)架构下可靠服务模型所需的最低带宽,同时也是理解 KV cache 效率的良好指标。预填充时间体现了模型架构的效率,随着序列长度增加,我们会看到内存受限和计算受限两种情况。如下表所示,随着序列长度增加,混合线性注意力的优势变得更加明显。

来源:Prefill-as-a-Service:下一代模型的 KVCache 可能跨数据中心(Prefill-as-a-Service: KVCache of Next-Generation Models Could Go Cross-Datacenter)
这也是理解将 KV cache 卸载到集群中不同内存层级时带宽需求的好方法。
KV cache 的存储位置遵循内存层级(memory hierarchy)。首先,KV cache 驻留在 GPU 集群中最快的内存 HBM 中,消耗模型权重和激活之外剩余的所有容量。当 KV cache 超出 HBM 容量后,它会溢出到服务器 DRAM——一个容量更大但带宽更低的内存池。最后,当 KV cache 超出 DRAM 容量时,它会溢出到 SSD 等磁盘存储。这与计算机体系结构中的缓存层级类似:寄存器、缓存、主存、磁盘存储。
这种类比在内存一致性上同样成立。流行的分布式 KV cache 框架 Mooncake Store 支持 KV cache 加载的写穿(write-through)和写回(write-back)策略。Mooncake Store 提供了一个分布式 KV cache 池,使所有 worker 都能看到全部 KV cache。在 DRAM 与底层分布式 KV cache 池之间实现写穿策略,在多节点场景下有多重好处,包括跨节点共享前缀缓存(prefix cache)、避免张量并行 MLA 的 KV cache 重复存储,以及在节点宕机时提供 KV cache 冗余。

来源:SemiAnalysis
在请求的每个 token 位置,Kimi K3 的 KDA 循环状态大小固定不变,而标准注意力的 KV cache 随序列长度增长。这种 KV cache 空间的缩减是以复杂化前缀缓存为代价的,尤其当 Kimi K3 是 KDA 与 MLA 的混合注意力时。
粗略地说,现代推理引擎通过匹配现有缓存中最长的 token 前缀来识别前缀缓存命中。

来源:SemiAnalysis
对于 KDA 这类线性注意力,识别最长前缀成为一个难题。如果预先不知道前缀的边界在哪里,我们就必须在每个 token 位置缓存 KDA 的循环状态。这意味着每个 token 都有一个缓存,KV cache 内存用量退回到随序列长度增长,从而违背了使用线性注意力的初衷。为解决这一问题,Moonshot 以较粗的粒度保存循环状态,例如 vLLM 每 32K token 缓存一次。vLLM 还会在 prompt 边界处额外缓存,因为对于智能体工作负载,新的一轮对话通常从 prompt 末尾开始。

来源:Kimi K3 来了:vLLM 上的高效 Day-0 支持(Kimi K3 Is Here: Efficient Day-0 Support on vLLM)
这表明,尽管 KDA 这类线性注意力大大降低了 KV cache 的内存消耗,但在实际推理服务中,它们消耗的 KV cache 内存并非恒定不变的。
残差连接是让我们能够通过增加模型深度来构建更大深度神经网络的关键创新之一。神经网络越深,表达力越强,但朴素地训练它们很困难。早期层的信号需要一直保留到最后一层,梯度也需要从输出端一路传播到第一个层而不消失。
残差网络不再把整个网络建模为单一函数、仅通过非线性变换传递信息,而是用恒等路径(identity paths)连接较小的模块。每个模块 fᵢ 学习对其输入 xᵢ 的一个增量,由以下递推关系给出:
\[
x_{l+1} = x_l + f_l(x_l)
\]
恒等映射使特征能够从较浅的单元直接传达到任意较深的单元,并为梯度提供了一条高速公路式的路径,使其不会消失。
\[
\frac{\partial x_{l+1}}{\partial x_l} = I + f_l’(x_l)
\]
虽然残差连接让我们能够构建更深的网络,但它们也带来了挑战。
早期层对残差流(residual stream)的影响极大,从而作用于最终输出。因此,随着深度增加,残差流会出现不可逆的信息损失。后期层会提高输出增益以作用于这个已被修改的残差流,这可能使训练不稳定。另一种变体如高速网络(highway networks)允许通过门控机制控制信息流,但它们存在同样的关键问题:各层无法选择性地访问来自更早层的信息。
以循环神经网络(RNN)为主导的序列建模有着同样的递推形式。
\[
h_{t+1} = h_t + f(h_t, x_{t+1})
\]
其中每一步都通过与前一步状态的恒等映射实现直接信息流,而序列模型面临着同样的挑战:时间轴上的深度会稀释信号。

来源:SemiAnalysis
基于注意力的 Transformer 通过强大而昂贵的注意力机制检索过去任意 token,从而摆脱了这一限制。
受序列建模中注意力机制的启发,Moonshot 开发了注意力残差(Attention Residuals),即在深度维度上对各个层块做注意力:

来源:Attention Residuals
标准的因果自注意力将 token $t$ 的输出计算为之前 token 表示的加权和:
\[
\mathbf{o}_t
=
\sum_{i=1}^{t}
\alpha_{i\rightarrow t}\,\mathbf{v}_i,
\qquad
\alpha_{i\rightarrow t}
=
\frac{\phi(\mathbf{q}_t,\mathbf{k}_i)}
{\sum_{j=1}^{t}\phi(\mathbf{q}_t,\mathbf{k}_j)}
\]
注意力残差使用同样的注意力机制,但将序列维度替换为深度维度。每一层不再对之前的 token 做注意力,而是对之前各层产生的表示做注意力。

来源:SemiAnalysis
与标准注意力不同,这里的 query 是每一层学习得到的参数,而不是由当前 token 生成的。
\[
\alpha_{i \to l}
=
\frac{\phi(\mathbf{q}_l,\mathbf{k}_i)}
{\displaystyle\sum_{j=0}^{l-1}\phi(\mathbf{q}_l,\mathbf{k}_j)}
\]
对于每一层 ℓ,我们定义:
\[
\mathbf{q}_l=\mathbf{w}_l,
\qquad
\mathbf{k}_i=\mathbf{v}_i=
\begin{cases}
\mathbf{h}_1, & i=0,\\
f_i(\mathbf{h}_i), & 1\le i
每个彩色块代表前一个 Transformer 层的输出 token 表示。正如标准的因果自注意力对序列中的 token 执行 softmax 注意力,注意力残差对之前各层产生的表示执行 softmax 注意力。

来源:SemiAnalysis
注意力残差让模型能够精细控制从过去的层中选择哪些输入,从而增强模型的表达能力。
注意力残差需要对所有过去层的输出做注意力。对于分布在许多 GPU 上的大型模型,这会产生 O(Ld) 的通信开销。为克服这一问题,分块注意力残差将 L 层划分为 N 个块,每个块包含 S 层。分块注意力残差对已完成块的输出做注意力,对于当前块则使用其不断演化的部分和。

来源:SemiAnalysis
分块注意力相比完整注意力残差几乎没有损失,但将通信量从 O(Ld) 降至 O(Nd)。
令 bₙⁱ 表示块 n 中前 i 层的部分和,即
\[
\mathbf{b}_n=\mathbf{b}_n^S,
\qquad
\mathbf{b}_0=\mathbf{h}_1.
\]
对于块 $n$ 中的第 i 层,可用的块表示为
\[
\mathbf{V}_l=
\begin{cases}
[\mathbf{b}_0,\mathbf{b}_1,\ldots,\mathbf{b}_{n-1}]^\top,
& i=1,\\[4pt]
[\mathbf{b}_0,\mathbf{b}_1,\ldots,\mathbf{b}_{n-1},
\mathbf{b}_n^{i-1}]^\top,
& i>1.
\end{cases}
\]
与标准注意力不同,query 不依赖于输入。每一层学习一个查询向量:
\[
\mathbf{q}_l=\mathbf{w}_l
\]
各可用块表示上的注意力权重计算如下:
\[
\boldsymbol{\alpha}_l
=
\operatorname{softmax}
\left(
\mathbf{K}_l\mathbf{w}_l
\right).
\]
输出是前几层表示的加权和:
\[
\mathbf{h}_l
=
\boldsymbol{\alpha}_l^\top\mathbf{V}_l.
\]
注意力残差不再仅依赖残差流来保存信息,而是让每一层都能直接、有选择地访问更早的表示。这种基于块的注意力残差变体在性能有竞争力的同时,大大降低了通信开销。
与标准残差连接相比,分块残差表现出更好的扩展性,实现了 1.25 倍的计算效率。验证损失始终低于基线,且差距在衰减阶段不断扩大。与标准残差网络中输出幅度随深度增加而增大的情况不同,分块注意力的选择性聚合使得输出有界,梯度幅度也保持一致。
与标准残差网络不同,注意力残差需要所有 N-1 个块的输入来计算第 N 层。这对流水线并行(pipeline parallelism)来说是个问题,因为所有 N 层块的输出都需要跨 stage 传输。
借助巧妙的跨 stage 缓存和激活检查点(activation checkpointing),Kimi 将流水线并行的开销相比标准架构降至仅 4%。
设有 P 个物理 stage 和 V 个虚拟 stage。每个块 N 对每个 chunk 需要 C=PV 次通信。朴素实现需要对每个 stage 传输所有已累积的块,这会使每个物理和虚拟 stage 的通信成本呈二次方增长:
\[
\mathrm{Comm}_{\mathrm{naive}}
=
\sum_{j=1}^{C-1} jN_p \cdot d
=
\frac{C(C-1)}{2}N_p d
\]
通过在虚拟 stage 之间缓存输入,可以降低这种高昂的通信成本。在更早层计算出的块可以存储在本地内存中:

来源:SemiAnalysis
对于第一个虚拟 stage,物理 stage 中需要传输所有块的嵌入,每个已完成块存储在对应的 rank 上。对于所有后续虚拟 stage,所有已缓存的块都可以复用于计算。只有 rank 上不存在的块才需要为注意力残差计算而传输。

来源:SemiAnalysis
这分别计算了第一个虚拟 stage 和后续虚拟 stage 的通信成本。第一个虚拟 stage 需要对所有物理层承担同样的二次方成本。在后续虚拟 stage 中,我们使用本地设备的缓存输入,只需传输 PNp 个 chunk,将总通信量从 O(C) 降至 O(P):
\[
\mathrm{Comm}_{\mathrm{cached}}
=
\underbrace{\frac{P(P-1)}{2}N_p d}_{\text{first virtual stage}}
+
\underbrace{(V-1)P^2N_p d}_{\text{subsequent virtual stages}}
\]
通信量的削减与虚拟 stage 数 V 成正比。正因为如此,在一次完整的前向与反向传播中,所有计算和通信都可以重叠。
由于跨 stage 缓存,所有块在所有 V 个虚拟 stage 中只存储一次。借助激活检查点,所有用于注意力的块间 chunk 都被消除。每个 stage 的激活检查点 Pl 与标准架构的 Hl 内存大小相当,没有额外的内存开销。
由于注意力残差需要所有之前块的输出来计算注意力,朴素实现会有过多的内存访问。为降低开销,推理被分为两个阶段,分别对应自回归注意力的预填充和解码阶段。计算被划分为:对已完成块的块间注意力(inter-block attention),以及对运行中块内不断演化的注意力的块内注意力(intra-block attention)。

来源:SemiAnalysis
在解码过程中,我们需要输出已完成的块和每层学到的查询向量。所有块间层通过单个批处理查询同时针对已完成块的表示进行注意力计算,返回输出和 softmax 统计量,这些统计量可复用于后续计算。这一阶段类似于预填充阶段的解码。

来源:SemiAnalysis
这一阶段类似于解码阶段。与 flash attention 类似,块内不断演化的和可以用在线 softmax(online softmax)计算,并与预计算的块间结果相结合,从而减少冗余的内存访问。
通过这种两阶段设计,IO 足迹与标准残差架构相当,仅额外增加了阶段一的块间计算,而该成本通过对块内所有查询进行批处理而被摊薄。
LatentMoE 在分派(dispatch)操作之前压缩被路由的 token,然后在聚合(aggregation)操作之后将其解压。在 Kimi K3 的 Stable LatentMoE 中,他们在升维投影(解压)操作之前应用 RMSNorm,以降低对尺度变化的敏感性并提升模型性能。

来源:Kimi K3 技术报告
这里我们解释 LatentMoE 关于 MoE 通信的设计原理。如 LatentMoE 论文所示,通信量与总路由 token 数 t、活跃专家数 K 和专家输入维度 d 成正比,与专家并行规模 E 成反比。这可能是 Kimi K3 潜变量 MoE 维度大小和活跃专家数配置背后的原因。Kimi K2 系列采用 8 个活跃专家、输入维度 7168;因此 Kimi K3 的潜变量输入维度为 3584(7168 的一半),就能在不增加通信量的情况下将活跃专家数翻倍到 16。
然而,通信时间与计算时间的比值对于评估系统效率可能更为重要(相关讨论见此处和此处)。该比值反映了在吞吐受限(throughput-bound)区间内,MoE 内核将通信与计算重叠的能力上限(roofline),而专家中间维度大小是唯一影响该比值的模型配置。具体来说,增大专家中间维度会降低该比值,意味着理论上可被隐藏的通信比例上限更高。这里我们推导该公式:
t:专家并行(EP)域内的总输入 token 数
K:每个 token 的活跃专家数
N:专家总数
E:EP 域内的 rank 数
d:专家输入维度
m:专家中间维度
P:每个激活元素通信的聚合字节数(分派 + 合并)
F:每个 GPU 的有效 FFN 专家(建模为 SwiGLU)计算吞吐量,FLOP/s
B:每个 GPU 的有效单向网络带宽,B/s
假设专家路由均匀,每个 GPU 被分配 t * K / E 个 token
假设专家路由均匀,平均 1/E 的 token 对源 GPU 来说是本地的,因此每个 GPU 分派 (t*K/E) * (1-1/E) 个 token
每个 token 是 d 维向量,因此每个 token 的通信量为 d * P
每个 GPU 的通信量为 (t*K/E) * (1-1/E) * d * P
通信时间 T_comm = (t * K * d * P) / (E * B) * (1-1/E)
SwiGLU 计算涉及 3 次矩阵乘法:
Up(第一个)投影:d 到 m
Gate 投影:d 到 m
Down(第二个)投影:m 到 d
因此每个 token 的计算量为 2*d*m + 2*d*m + 2*m*d = 6*d*m 次 FLOPs
每个 GPU 的计算时间为 T_comp = (6*d*m) * (t*K/E) / F
通信时间与计算时间的比值为
T_comm / T_comp
= ((t * K * d * P) / (E * B) * (1-1/E)) / ((6*d*m) * (t*K/E) / F)
= (P*F) / (6*m*B) * (1-1/E)
我们相信这一公式也推动了专家中间维度增加到 3072 的趋势——不仅 Kimi K2 到 K3 如此,所有近期的开源权重模型(包括 DeepSeek V4 Pro、MiniMax M3、MiMo V2.5 Pro 和 Inkling)都是如此。随着硬件进步、专家权重精度降低以节省内存容量,计算吞吐量随之提升,因此降低该比值的一种方式就是增大专家中间维度。

来源:Kimi K3 技术报告
许多以往的负载均衡方法都需要精心调参。分位数均衡(Quantile Balancing)是苏剑林(Jianlin Su)在 2026 年 2 月的博客文章中提出的负载均衡技术,它无需超参数、也无需辅助损失(aux-loss)。
分位数均衡的基本原理与无辅助损失(aux-free)负载均衡相同,即根据系统的负载动态更新路由器偏置(bias)。但与无辅助损失负载均衡用某个小系数更新偏置不同,QB 根据路由器得分相对于路由截断阈值的分布直接计算下一次偏置。当路由器均匀平衡负载时,偏置更新自然变小。

来源:Kimi K3 技术报告
QB 试图在当前截断和当前批次路由下找到能够近似实现负载均衡的偏置,通过求解带约束的优化问题,并将这些更新应用到下一批次。第一个约束是每个 token 恰好被路由到 k 个专家。第二个约束是:一批 m 个 token,每个选择 k 个专家,总共产生 (mk) 个分配;要使负载均匀分布到 n 个专家,每个专家应处理 $q=mk/n$ 个 token。
每个 token 将偏置后的路由器得分中第 (k+1) 高的值作为截断阈值,并据此计算每个专家所需的偏置更新。对于每个专家,QB 对其路由器得分与每个 token 截断值之间的边距(margin)进行排序,将偏置设为负的第 q+1 大边距,恰好留下 q 个边距在阈值之上。由于 q/m=k/n,这正是边距的 (1-k/n) 分位数,故得名分位数均衡。
我们正在 InferenceX 上积极追踪 Kimi K3 的推理性能。
截至 7 月 30 日,OpenRouter 上所有服务商的价格下限为输入 $3 每百万 token、输出 $15 每百万 token。Nvidia 和 AMD 都在 vLLM 上提供了 Day 0 方案,主打 DRAM 卸载(DRAM offload)和 DSpark 投机解码(speculative decoding)。

来源:OpenRouter
在 InferenceX 上,我们直接使用录制的内部 Claude Code 轨迹对 Kimi K3 的推理服务性能进行基准测试。我们回放一个小时的轨迹直至达到稳态。每轮对话的输入 token 中位数为 142k,输出 token 中位数为 444,每个会话的中位数有 65 轮。每轮较短的输出 token 是智能体框架(agentic harnesses)上工作负载的典型特征——智能体会频繁调用工具,连编辑操作都算作工具调用。
这一基准测试相比我们之前的 8k1k/1k1k 基准是一个重大升级,因为它真正反映了现实世界的智能体用例。从系统角度看,它同样贴近实际,最接近生产系统。它能反映 KV cache 的行为,包括前缀缓存和 KV 卸载到 DRAM。

来源:InferenceX
对于 Kimi K3 来说,Day 0 的启动(bringup)比 DSv4 更容易,这得益于更好的文档以及权重发布前的充分准备。合适的镜像和一个投机解码器模型与权重同时发布。