埃隆·马斯克又一次震惊了世界:他在 SpaceX 的首次财报电话会上,宣布了明年冲击吉瓦级(GW)的雄心。他"保守地"计划仅在 2027 年就新增建设并交付 6-8GW,而这一数字的潜力远超 +10GW。按每 GW 500 亿美元计算,这意味着 2027 年 3000-5000 亿美元的资本开支(capex),与我们对 AWS 和 Google 的预期相当——对于一个盈利能力远低于竞争对手超大规模云厂商的公司来说,这是一个令人难以置信的数字。
然而,我们相信这个数字是真的。我们看到 SpaceX 有望在 2027 年底前建成约 10GW。我们已经评估了所有适合 SpaceX 的选址,并把清单提供给了我们的 Datacenter Model(数据中心模型)订阅用户。我们的 Energy Model(能源模型)订阅用户还拥有一份按季度细分的燃气发电设备精确清单,覆盖 30 多家汽轮机、发动机、燃料电池供应商。在市场意识到这一点之前,我们就已提供了其中大部分数据。下面,我们来讨论埃隆是如何绕开典型的数据中心建设瓶颈的。
正如我们在《Meta Compute》深度报告中解释的那样,"大规模 + 近期可用"的算力是一种极为稀缺的组合,其定价溢价极高——高达 $50B/GW/年。不过,AI 实验室能消化这个价格,并从中获得丰厚利润。
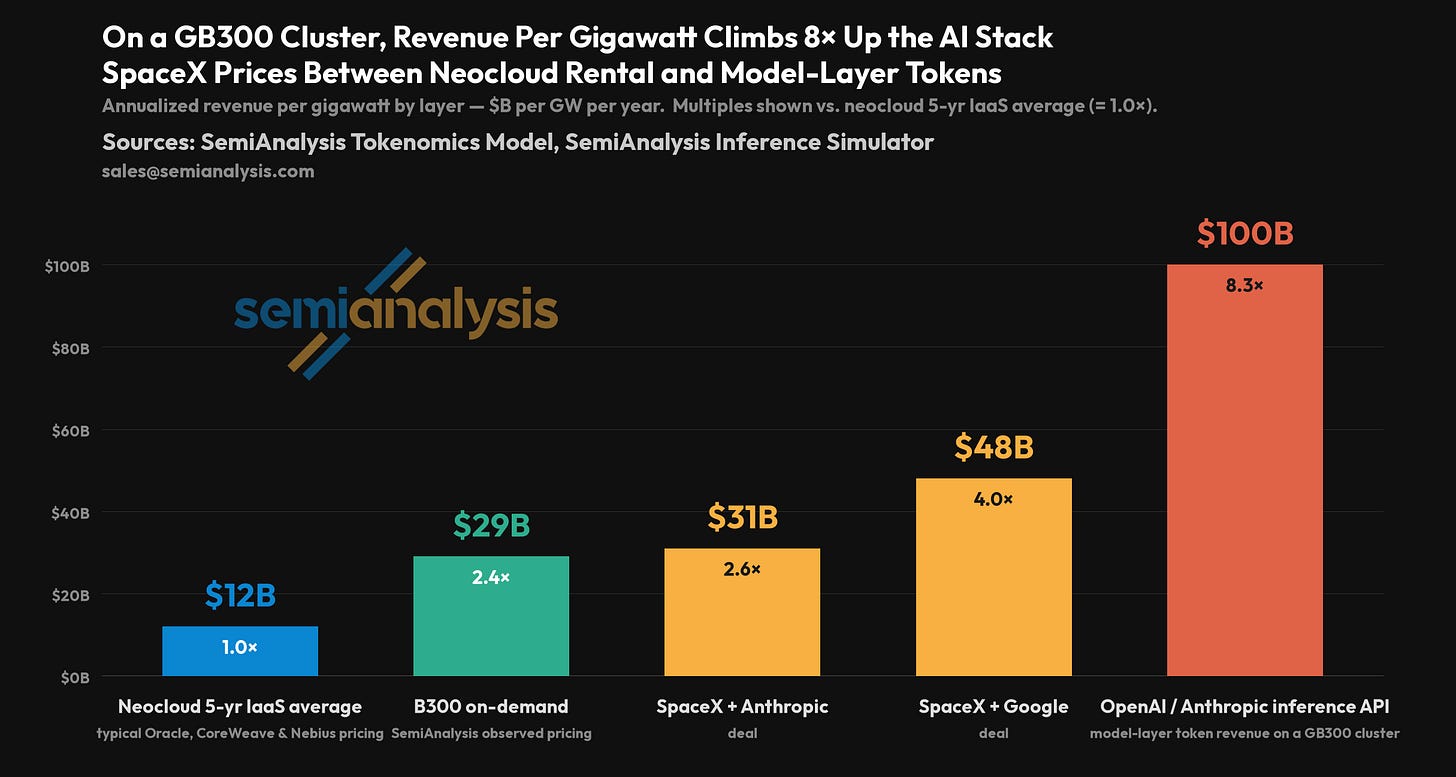
我们的 Tokenomics Model(代币经济学模型)和 Inference Simulator(推理模拟器)表明,在现实的性能水平下(例如每张 GPU 每秒生成的 token 数),OpenAI 和 Anthropic 都能通过在 GB300 集群上售卖 API 推理服务,产生超过 $100B/GW/年的收入。这远高于按当前 neocloud(新型云服务商)价格租用 GB300 集群一年的成本。
对于前沿模型公司来说,提供推理 token 服务的利润高得令人难以置信。
来源:SemiAnalysis Tokenomics Model、SemiAnalysis Inference Simulator
我们假设每年约 $12B/GW/年的成本,采用保守的 $3/GPU-小时的租赁单价,并使用我们的 Inference Simulator,以前沿级模型架构和我们的智能体编码基准 AgentX(InferenceX 的一部分,通过收集真实的生产编码轨迹构建)来估算 token 产量。我们按真实的工作负载比例,在输入、缓存读取(cache-read)、缓存写入(cache-write)和输出 token 成本之间混合该 token 产量,得出最终估算结果——超过 $100B/GW/年。
作为背景说明,我们的 Inference Simulator 是从零开始构建的,其基础是对现代 AI 加速器工作原理的根本性理解。我们为前沿模型在推理过程中的运行方式构建了一个 roofline(性能上限)模型和现实的性能模型,包含每个操作的耗时和真实的 trace 输出。它是对真实工作负载在真实芯片上执行情况的端到端模拟。我们已在广泛的加速器和工作负载上验证了该模拟器的保真度,并持续改进其根据设计规格准确预测未来加速器性能的能力。

对硅片上端到端模拟工作负载执行的细粒度数据采集,可生成真实的 profiler 追踪记录,供 Perfetto 等标准工具分析。来源:SemiAnalysis Inference Simulator

跨常见的推理工作负载与硬件平台,在帕累托前沿(pareto frontier)上生成高层次的性能预估。来源:SemiAnalysis Inference Simulator
如需了解我们如何将 Inference Simulator 应用于定制研究与分析,请联系 sales@semianalysis.com。
除了 OpenAI 和 Anthropic,世界上实际上还有第三家公司具备这种每 GW 的印钞级经济性:微软。凭借对 OpenAI 模型的完全访问权,他们可以在不承担任何训练成本的情况下,产生完全相同的每 MW 收入和利润率。萨蒂亚(Satya)在 OpenAI 谈判中大获全胜:2026 年 4 月重谈的协议把旧的 20% 收入分成从交易中拿掉了。简而言之,微软有巨大的动力去尽快采购尽可能多的 MW。虽然他们目前的大部分数据中心容量以约 $14M/MW/年的价格提供给 OpenAI,但他们有机会优化这一结构。潜在的影响是,微软 Azure 的收入增速有望在明年从约 42% 跃升至超过 100%。这是一个千载难逢的机会,而 SpaceX 正是极佳的承接者。

来源:SemiAnalysis Tokenomics Model
微软与 SpaceX 以 $50B/GW/年的价格签下 3GW,听起来简直疯狂,但我们认为这有可能,原因有二:
1/ 微软已经在为一场史诗级的数据中心扩张做准备。如下文所述,他们今年迄今(YTD)已签署了 10GW 的合同,总合同价值超过 $300B(不含 GPU 成本)。我们预计还会有更多合同签署。需要注意:这些合同对应的是 2027 年底和 2028 年的产能。短期内仍有缺口需要填补。
2/ 与 SpaceX 和 Anthropic、Google 的协议类似,合同附带 90 天取消条款,资产负债表零风险。考虑到收入机会,这让 Amy Hood(微软 CFO)签下这笔交易变得异常容易。
对 SpaceX 而言,下一个自然而然的问题是融资。在没有顶级超大规模云厂商那样雄厚资产负债表的支持下,埃隆如何负担如此巨大的资本开支?我们预计会是以下两者的结合:
1/ 英伟达(Nvidia)的支持,以供应商融资(vendor financing)的形式降低前期现金成本。这很可能就是埃隆在财报电话会上宣布独家采用 Nvidia 的原因!正如我们的 Accelerator Model(加速器模型)反复解释的那样,xAI/SpaceX 曾积极评估过 TPU、AMD 等替代方案——财务上的考量很可能让他们放弃了这些选择,转而专注于 Nvidia。
2/ 由行业最高定价驱动、以最快交付周期为前提的运营现金流融资:SpaceX 将继续以 3-5 个月的交付周期销售大规模算力——这是无可匹敌的产品,并按 $30-50M/MW/年定价。不到一年即可收回资本开支。我们在《Meta Compute》一文中深入讨论过这一点。
这意味着 SpaceX 到 2027 年底有望实现 $300B 的年经常性收入(ARR)。这一假设仅把其 2027 年新增算力的 50% 用于变现,其余留给 Grok 与 Cursor 团队用于训练(未计入推理收入)。

来源:SemiAnalysis Tokenomics Model
现在让我们深入分析。先从微软说起——它终于惊人地醒了过来:去年的暂停已逆转,今年迄今已签署 10GW 的具有约束力的合同。我们将简要讨论如何达到每 MW/年 $100M 的推理收入的经济学。然后转向 SpaceX,分析他们的数据中心扩张,以及到 2027 年底实现 10GW+ 的可行性。
2024 年 12 月,我们最早在 Datacenter Model 中指出微软租赁活动的急剧暂停。今天,这家巨头苏醒了。我们的模型按季度跟踪租赁活动、neocloud 签约、自建项目开工,以及大规模有约束力的购电协议(PPA)和能源服务协议(ESA)。下图展示了跟踪结果。微软在这些层面合计签约超过 10GW,相当于约 $300B 的新增有约束力承诺。

来源:SemiAnalysis Datacenter Model
这次觉醒的一个关键原因是,他们迫切需要算力来抓住每 MW/年 $100M 的收入机会。微软于 2025 年 10 月与 OpenAI 签署了一份 $250B 的协议,我们在 Tokenomics Model——世界上理解"美元到瓦特"换算细节的最佳工具——中估算其总量约为 7GW。这笔庞大的基础设施即服务(IaaS)交易,让微软在其他用例上严重受制于算力短缺。他们一直无法将访问 OpenAI 模型的权利,用于自己的 API 业务 Foundry,或 Copilot 等应用。
然而,这些恰恰是每 MW 利润率和收入最高的服务,且遥遥领先。我们在《AI Value Capture》一文中对此做过深入解释。
而这正是微软每 MW $100M 的机会所在。鉴于近期 Codex 需求激增、以及 OpenAI 相应加速的 ARR,我们认为微软通过提供 OAI 模型推理服务,也能以类似水平将算力变现。
现在,为了抓住这个千载难逢的机会,微软和 AI 实验室都需要数据中心,而且要又快又大。SpaceX 已经两次证明他们能比别人建得更快,但到 2026 年底,他们的算力容量"仅仅"是 2GW。他们真的能在 2027 年这一整年里建成 10GW+ 吗?
在《Meta Compute》一文中,我们深入解释了埃隆为何再次证明自己是商业天才。他明白 AI 实验室的利润率已大幅飙升,因此为他的 GPU 集群引入了"基于价值的定价"(value-based pricing),而非更常见的"成本加成"(cost plus)。
要让这台机器持续运转,埃隆需要以比任何人都快的速度建设数据中心。我们相信他做得到。是什么给了我们这种信心?我们已经多次写过埃隆的速度:122 天建成 Colossus 1 的 300MW,六个月在 Colossus 2 建成 200MW,决定在边境 1 公里外建设现场发电厂以规避审批,以及更多。
自那以后,还有更多速度的展示。Southaven 的发电厂已从 2026 年 2 月的 27 台汽轮机(约 495MW)扩张到 2026 年 7 月的 69 台(1.7GW)。


来源:SemiAnalysis Datacenter Industry Model;Southaven 发电厂,2026 年 2 月至 2026 年 7 月
还有"MiniHard"的到来:它于 2026 年 3 月开始主体结构施工,预计仅用约 5 个月即可达到 450-500MW!这并不意味着埃隆比其他人建得更好。他只是应用了一套不同的打法。
开关柜和大型电力变压器(LPT)已售罄到两年之后?那就从中国购买电力模块,绕开 LPT,把发电端的中压电力直接送到供应充裕得多的低压变压器。埃隆的公司拥有世界上最优秀的电气工程师——没有人比他们更懂得如何在速度与效率之间取舍。世界上大多数数据中心运营商的优化目标是效率和质量——这是拿到超大规模云厂商 15-20 年照付不议(take-or-pay)数据中心合同的唯一途径。SpaceX 则专注于完全不同的取舍:速度高于一切。在算力紧缺、AI token 利润率极高的时代,一个三个月内可用、附带 90 天取消条款的 500MW 集群,是世界上最稀缺、最有价值的资产之一。所有常规的"质量"指标都不重要。证据?Google——世界上垂直整合程度最高的基础设施公司——居然最终与 SpaceX 签了约。
燃气轮机排产积压 5 年以上?GEV(GE Vernova)确实如此,但还有大量其他选择——我们的 Energy Model 收录了 30 多家已拿到大规模订单、服务数据中心的燃气发电设备制造商。只要你愿意努力寻找、愿意与新供应商合作,就有大量可用产能。涡轮机的二手市场交易量正在飙升——例如,原本计划供应 Oracle 新墨西哥州机场所用的汽轮机,现在全部流入了市场。二手市场价格非常高,但埃隆付得起。
劳动力是终极瓶颈?那就尽可能多地并行作业、简化调试流程、尽量预组装。据报道,Colossus 2 的峰值日用工约 3,000 名建筑工人,比其他在建的吉瓦级数据中心低了大约一个数量级(约 10 倍)。埃隆一直有着用少于行业标准的人员取得成就的悠久历史——看看特斯拉和 SpaceX 的历史就知道了。


来源:SemiAnalysis Datacenter Industry Model;MiniHard,2026 年 3 月至 2026 年 7 月
这为在 2027 年之前建成多个这样的外壳留出了绰绰有余的时间。这也是他第一个真正的绿地(greenfield)项目,所以下一个项目他很可能做得更好。当然,另一种选择是改造(retrofit)。正如我们去年的 xAI 深度报告所述,Colossus 1 和 2 正是通过改造以惊人的速度建成的。
一年内建成 10+GW 将是另一回事。SpaceX 需要在全美各地寻找合适的土地——审批容易、且能获得燃气供应。不过我们认为,可选的方案绰绰有余,足以支撑一次实质性的扩张。这自然将在很大程度上依赖现场燃气发电——点此查看我们的能源深度报告,了解其运作原理与必要性。
在付费墙之后,我们将讨论一些我们猜测埃隆可能会拿下的选址。